GPU-сервер Supermicro SYS-821GE-TNHR б/у (8x H100 SXM 80GB, 2x Xeon Platinum 8468, RAM 2TB)
Арт. SB-00019265 857 900 ₽с НДС
Под заказ · 3–5 недельПоставка через офис в ГонконгеВосемь ускорителей SXM на плате HGX, связанные NVLink и NVSwitch, — платформа для обучения крупных моделей и инференса LLM на сотни миллиардов параметров.
61 товар · цены для юрлиц с НДС и без НДСЦены не являются публичной офертой (ст. 437 ГК РФ) — стоимость оборудования и доставки уточняется по заявке.
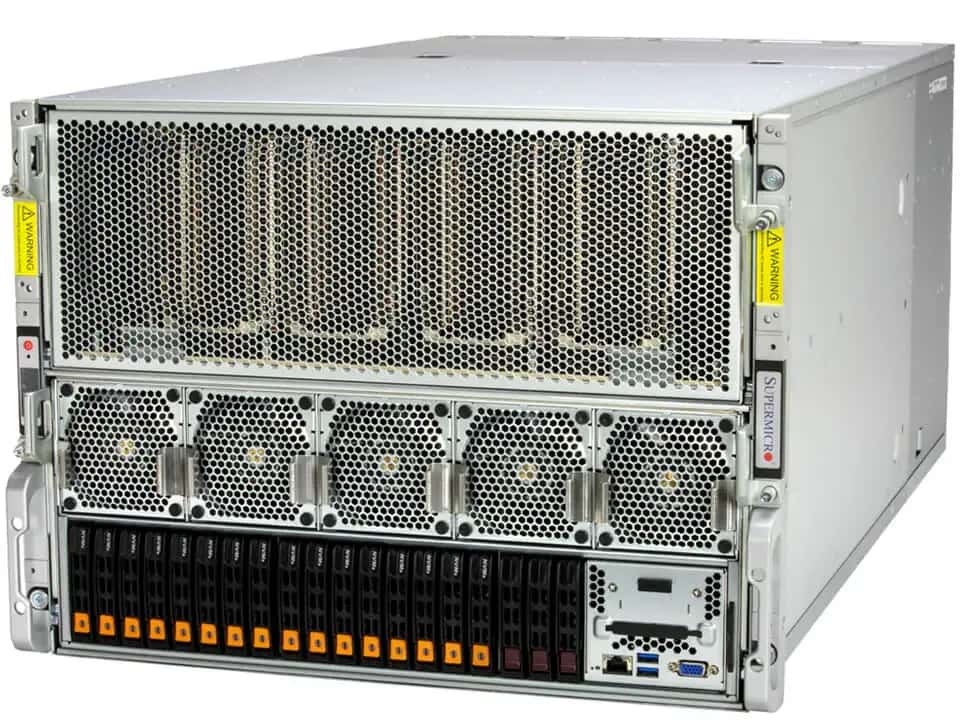
Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) · Процессор (CPU): Intel Xeon · Видеокарта (GPU): NVIDIA H100 · Количество GPU, шт: 8
Арт. SB-000192Закупаете партию для ИИ-фермы? Подготовим КП с ценой за объём
Пришлите список моделей и количество — ответим коммерческим предложением с НДС и сроками поставки.HGX — это плата с восемью модулями SXM, которые обмениваются данными через NVLink и NVSwitch в обход шины PCIe. Производители серверов ставят её в свои шасси с процессорами, памятью и сетью, а NVIDIA выпускает на ней системы DGX. Когда модель не помещается в одну карту, такая связность заметно ускоряет обучение и инференс.
Поколение выбирают по объёму памяти и поддерживаемой точности. H200 на архитектуре Hopper — 141 ГБ HBM3e на GPU и около 1,1 ТБ на узел, отлаженная платформа для инференса и обучения. B200 на Blackwell — 180 ГБ на GPU, вычисления в FP4 и NVLink пятого поколения. B300 (Blackwell Ultra) — 288 ГБ на GPU и около 2,3 ТБ на узел: из 8-GPU узлов, которые есть в каталоге, модели на 2–3 трлн параметров, например Kimi K3 (около 1,5 ТБ весов), вмещают только B300, AMD Instinct MI350X и MI355X с тем же объёмом на ускоритель и MI325X на 256 ГБ. H100 на 80 ГБ подойдёт, если меньшего объёма памяти достаточно. Следующее поколение NVIDIA — Rubin с памятью HBM4: платформы HGX Rubin NVL8 рассчитаны на жидкостное охлаждение.
Учтите инфраструктуру: узел на H200 потребляет порядка 10 кВт, на B200 и B300 — больше. Версии с воздушным охлаждением занимают от 5U до 10U, с жидкостным — компактнее, но требуют контура охлаждения и CDU. В кластере каждый GPU обычно получает свой сетевой порт InfiniBand или Ethernet на 400–800G.
Серверы на HGX выпускают Supermicro, GIGABYTE, ASUS, ASRock Rack, Dell (PowerEdge XE9680, XE9780) и HPE (Cray XD670). Закупаем их через наш офис в Гонконге, в КП указываем маршрут, сроки, страховку и таможенное оформление, а счёт выставляем с НДС.
HGX — плата с восемью GPU, которую производители встраивают в свои серверы. DGX — готовая система NVIDIA на той же плате со своей конфигурацией процессоров, памяти и сети.
141 ГБ HBM3e на каждый GPU, всего около 1,1 ТБ. Этого хватает, например, для Kimi K2.6 на 1 трлн параметров в родном INT4 (около 0,6 ТБ) или GLM-5.3 в FP8 (около 0,75 ТБ). DeepSeek V4-Pro (около 0,9 ТБ) помещается впритык, а поддержку его весов FP4 на Hopper нужно проверить в движке инференса.
B200 даёт больше памяти и аппаратно поддерживает FP4 — в этом формате выпускают многие новые модели, например DeepSeek V4 и gpt-oss, поэтому на Blackwell они работают быстрее. H200 подойдёт, если ПО уже отлажено на Hopper и важно меньшее энергопотребление узла.
Да: платформы на восьми ускорителях AMD Instinct MI300X, MI325X и MI355X с памятью от 192 до 288 ГБ на ускоритель. Они работают с ROCm вместо CUDA.
Для H200 и многих конфигураций B200 и B300 хватает воздушного охлаждения при достаточной мощности стойки. Варианты с жидкостным охлаждением компактнее, но требуют контура охлаждения и CDU в ЦОД.
Восемь ускорителей SXM на плате HGX, связанные NVLink и NVSwitch, — платформа для обучения крупных моделей и инференса LLM на сотни миллиардов параметров.
61 товар · цены для юрлиц с НДС и без НДСЦены не являются публичной офертой (ст. 437 ГК РФ) — стоимость оборудования и доставки уточняется по заявке.
Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) · Процессор (CPU): Intel Xeon · Видеокарта (GPU): NVIDIA H100 · Количество GPU, шт: 8
Арт. SB-000192Закупаете партию для ИИ-фермы? Подготовим КП с ценой за объём
Пришлите список моделей и количество — ответим коммерческим предложением с НДС и сроками поставки.HGX — это плата с восемью модулями SXM, которые обмениваются данными через NVLink и NVSwitch в обход шины PCIe. Производители серверов ставят её в свои шасси с процессорами, памятью и сетью, а NVIDIA выпускает на ней системы DGX. Когда модель не помещается в одну карту, такая связность заметно ускоряет обучение и инференс.
Поколение выбирают по объёму памяти и поддерживаемой точности. H200 на архитектуре Hopper — 141 ГБ HBM3e на GPU и около 1,1 ТБ на узел, отлаженная платформа для инференса и обучения. B200 на Blackwell — 180 ГБ на GPU, вычисления в FP4 и NVLink пятого поколения. B300 (Blackwell Ultra) — 288 ГБ на GPU и около 2,3 ТБ на узел: из 8-GPU узлов, которые есть в каталоге, модели на 2–3 трлн параметров, например Kimi K3 (около 1,5 ТБ весов), вмещают только B300, AMD Instinct MI350X и MI355X с тем же объёмом на ускоритель и MI325X на 256 ГБ. H100 на 80 ГБ подойдёт, если меньшего объёма памяти достаточно. Следующее поколение NVIDIA — Rubin с памятью HBM4: платформы HGX Rubin NVL8 рассчитаны на жидкостное охлаждение.
Учтите инфраструктуру: узел на H200 потребляет порядка 10 кВт, на B200 и B300 — больше. Версии с воздушным охлаждением занимают от 5U до 10U, с жидкостным — компактнее, но требуют контура охлаждения и CDU. В кластере каждый GPU обычно получает свой сетевой порт InfiniBand или Ethernet на 400–800G.
Серверы на HGX выпускают Supermicro, GIGABYTE, ASUS, ASRock Rack, Dell (PowerEdge XE9680, XE9780) и HPE (Cray XD670). Закупаем их через наш офис в Гонконге, в КП указываем маршрут, сроки, страховку и таможенное оформление, а счёт выставляем с НДС.
HGX — плата с восемью GPU, которую производители встраивают в свои серверы. DGX — готовая система NVIDIA на той же плате со своей конфигурацией процессоров, памяти и сети.
141 ГБ HBM3e на каждый GPU, всего около 1,1 ТБ. Этого хватает, например, для Kimi K2.6 на 1 трлн параметров в родном INT4 (около 0,6 ТБ) или GLM-5.3 в FP8 (около 0,75 ТБ). DeepSeek V4-Pro (около 0,9 ТБ) помещается впритык, а поддержку его весов FP4 на Hopper нужно проверить в движке инференса.
B200 даёт больше памяти и аппаратно поддерживает FP4 — в этом формате выпускают многие новые модели, например DeepSeek V4 и gpt-oss, поэтому на Blackwell они работают быстрее. H200 подойдёт, если ПО уже отлажено на Hopper и важно меньшее энергопотребление узла.
Да: платформы на восьми ускорителях AMD Instinct MI300X, MI325X и MI355X с памятью от 192 до 288 ГБ на ускоритель. Они работают с ROCm вместо CUDA.
Для H200 и многих конфигураций B200 и B300 хватает воздушного охлаждения при достаточной мощности стойки. Варианты с жидкостным охлаждением компактнее, но требуют контура охлаждения и CDU в ЦОД.