DGX Spark для разработчика
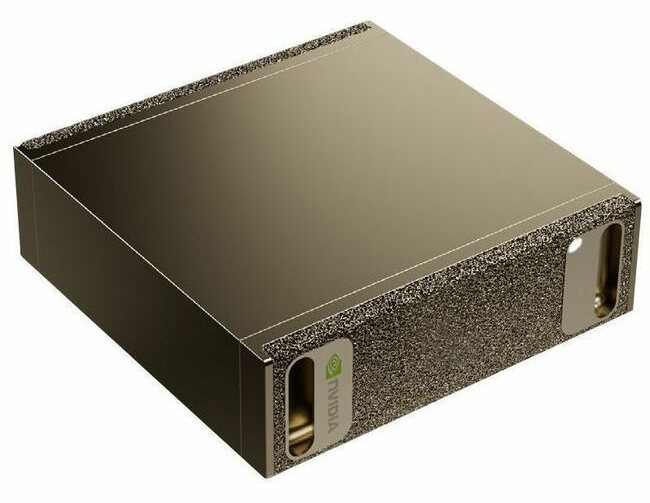
Настольный суперкомпьютер для прототипов и одного пользователя- ПлатформаNVIDIA GB10
- Память128 ГБ LPDDR5x, общая
- Скорость памяти273 ГБ/с
Видеопамять128 ГБ
от 1 085 200 ₽с НДС
Начните с задачи, а не с железа: подберём GPU, память и платформу под вашу модель и нагрузку. Сборка и тест под нагрузкой перед отгрузкой.
Для каждой задачи — таблица видеопамяти, готовые конфигурации и ответы инженера.
Опишите модель, число пользователей и бюджет — инженер соберёт конфигурацию и пришлёт КП.
Веса — число параметров × байт на параметр: 2 в BF16, 1 в FP8, 0,55–0,6 в 4 битах. У MoE считают все параметры, а не только активные. Сверху — KV-кэш: 2 × слои внимания × KV-головы × размер головы × байты × токены × пользователи, и около 10% на среду запуска. У плотной 70B кэш — 320 КБ на токен: 20 пользователей по 8K займут ~53 ГБ.
На 70–130B — Qwen3.5-122B-A10B, gpt-oss-120b или Mistral Small 4: веса в 4 битах занимают 63–74 ГБ, а на каждый токен считается 5–10 млрд параметров, поэтому ответ быстрее, чем у плотной 70B. Вместо R1 и V3 — DeepSeek V4: V4-Flash (~160 ГБ) идёт на 4 × RTX PRO 6000, новая V4.1-Flash (~0,51 ТБ) — на 8 × RTX PRO 6000 или 8 × H200, V4-Pro (~0,9 ТБ) — на 8 × B200 или B300. Для русского языка — GigaChat 3.5 (~435 ГБ в FP8): 4 × H200 NVL или 8 × RTX PRO 6000.
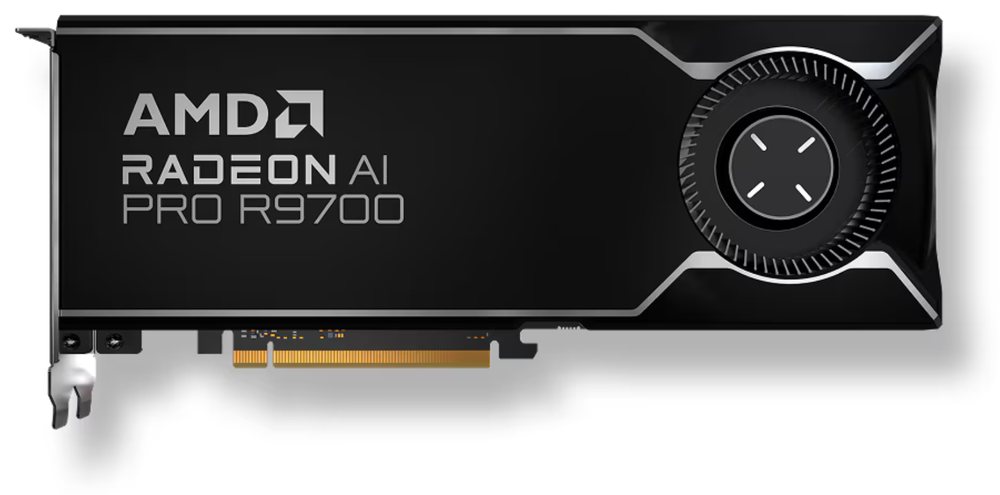
Да. Radeon AI PRO и Instinct работают с ROCm; заранее проверим поддержку вашей модели и фреймворка.
Да, каждый сервер проходит тест под нагрузкой. Отчёт о тестировании прикладываем к документам заказа.
Да, через офисы в Гонконге и ОАЭ. Маршрут и сроки — в коммерческом предложении.
Начните с задачи, а не с железа: подберём GPU, память и платформу под вашу модель и нагрузку. Сборка и тест под нагрузкой перед отгрузкой.
Для каждой задачи — таблица видеопамяти, готовые конфигурации и ответы инженера.
Опишите модель, число пользователей и бюджет — инженер соберёт конфигурацию и пришлёт КП.
Веса — число параметров × байт на параметр: 2 в BF16, 1 в FP8, 0,55–0,6 в 4 битах. У MoE считают все параметры, а не только активные. Сверху — KV-кэш: 2 × слои внимания × KV-головы × размер головы × байты × токены × пользователи, и около 10% на среду запуска. У плотной 70B кэш — 320 КБ на токен: 20 пользователей по 8K займут ~53 ГБ.
На 70–130B — Qwen3.5-122B-A10B, gpt-oss-120b или Mistral Small 4: веса в 4 битах занимают 63–74 ГБ, а на каждый токен считается 5–10 млрд параметров, поэтому ответ быстрее, чем у плотной 70B. Вместо R1 и V3 — DeepSeek V4: V4-Flash (~160 ГБ) идёт на 4 × RTX PRO 6000, новая V4.1-Flash (~0,51 ТБ) — на 8 × RTX PRO 6000 или 8 × H200, V4-Pro (~0,9 ТБ) — на 8 × B200 или B300. Для русского языка — GigaChat 3.5 (~435 ГБ в FP8): 4 × H200 NVL или 8 × RTX PRO 6000.
Да. Radeon AI PRO и Instinct работают с ROCm; заранее проверим поддержку вашей модели и фреймворка.
Да, каждый сервер проходит тест под нагрузкой. Отчёт о тестировании прикладываем к документам заказа.
Да, через офисы в Гонконге и ОАЭ. Маршрут и сроки — в коммерческом предложении.