GPU-сервер Supermicro SYS-821GE-TNHR б/у (8x H100 SXM 80GB, 2x Xeon Platinum 8468, RAM 2TB)
Арт. SB-00019265 857 900 ₽с НДС
Под заказ · 3–5 недельПоставка через офис в ГонконгеОт рабочих станций с одной картой до 8-GPU узлов HGX и стоек NVL72 — для обучения моделей, инференса LLM, RAG и рендеринга.
171 товар · цены для юрлиц с НДС и без НДСЦены не являются публичной офертой (ст. 437 ГК РФ) — стоимость оборудования и доставки уточняется по заявке.
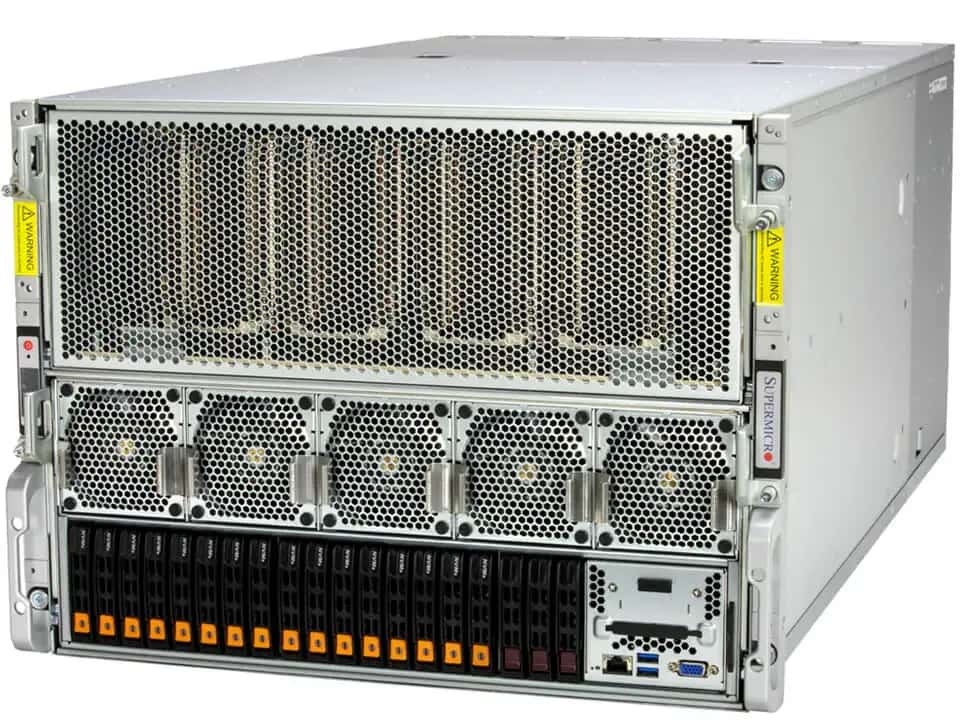
Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) · Процессор (CPU): Intel Xeon · Видеокарта (GPU): NVIDIA H100 · Количество GPU, шт: 8
Арт. SB-000192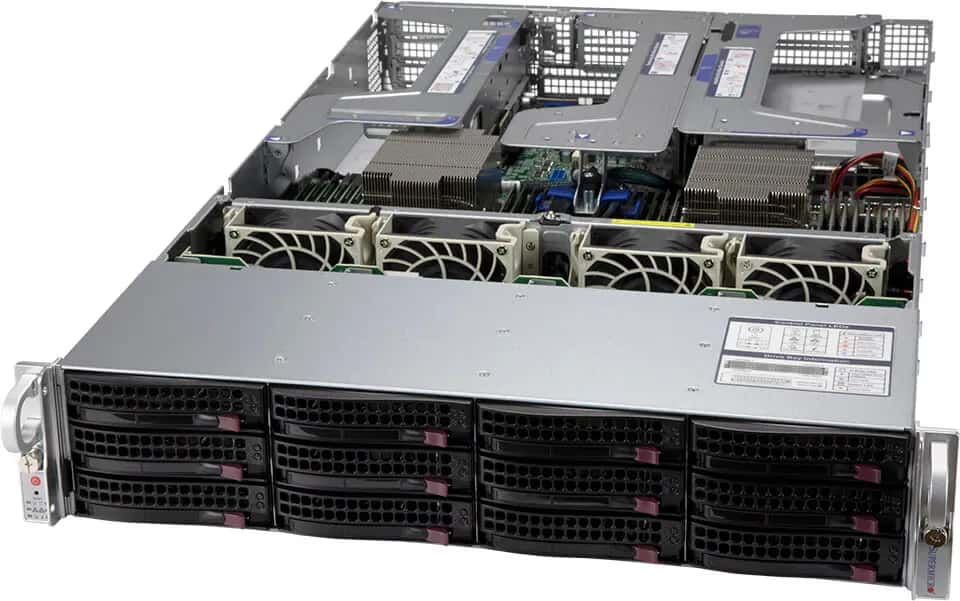
Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) · Процессор (CPU): AMD EPYC · Видеокарта (GPU): NVIDIA A100 · Количество GPU, шт: 3
Арт. SB-000161
Основная задача: Инференс / Дообучение моделей / RAG-системы / Анализ данных / Визуализация и рендеринг · Видеокарта (GPU): GIGABYTE Radeon AI PRO R9700 AI TOP · Количество GPU, шт: 4 · Общий объем видеопамяти (VRAM), ГБ: 128
Арт. SB-000138Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) / Визуализация и рендеринг · Процессор (CPU): Intel Xeon · Видеокарта (GPU): AMD Radeon Instinct MI100 · Количество GPU,
Арт. SB-000139Закупаете партию для ИИ-фермы? Подготовим КП с ценой за объём
Пришлите список моделей и количество — ответим коммерческим предложением с НДС и сроками поставки.Основная задача: Инференс / Дообучение моделей / RAG-системы · Процессор (CPU): Intel Xeon · Видеокарта (GPU): NVIDIA Tesla V100 · Количество GPU, шт: 6
Арт. SB-000140
Основная задача: Инференс / Дообучение моделей / RAG-системы / Анализ данных / Визуализация и рендеринг · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): GIGABYTE Radeon AI PRO R9700 AI TOP · Количество GPU, шт: 6
Арт. SB-000142Основная задача: Инференс / Дообучение моделей / RAG-системы · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): NVIDIA Tesla P100 · Количество GPU, шт: 6
Арт. SB-000143
Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) / Визуализация и рендеринг · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): AMD Radeon Instinct MI100 · Колич
Арт. SB-000148Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): AMD Radeon Instinct MI50 · Количество GPU, шт: 4
Арт. SB-000149Основная задача: Инференс / Дообучение моделей / RAG-системы / Анализ данных / Визуализация и рендеринг · Процессор (CPU): AMD EPYC · Видеокарта (GPU): GIGABYTE Radeon AI PRO R9700 AI TOP · Количество GPU, шт: 4
Арт. SB-000150Основная задача: Обучение моделей / Инференс / Дообучение моделей / Визуализация и рендеринг · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): AMD Radeon Pro WX8200 · Количество GPU, шт: 4
Арт. SB-000151Основная задача: Инференс / Дообучение моделей · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): NVIDIA Tesla P100 · Количество GPU, шт: 4
Арт. SB-000152Основная задача: Инференс / Дообучение моделей / RAG-системы · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): NVIDIA Tesla V100 · Количество GPU, шт: 4
Арт. SB-000153
Основная задача: Инференс / Дообучение моделей / RAG-системы · Процессор (CPU): AMD EPYC · Видеокарта (GPU): NVIDIA Tesla V100 · Количество GPU, шт: 3
Арт. SB-000160Начните с задачи: модель, точность и число одновременных пользователей определяют объём видеопамяти, а он — количество и тип ускорителей. Ориентир для инференса: в FP16 модель занимает около 2 ГБ на миллиард параметров, в FP8 — около 1 ГБ, в 4-битных форматах — около 0,6 ГБ, плюс запас под KV-кэш и контекст; у MoE-моделей считают все параметры, а не только активные. Qwen3.5-122B-A10B в FP8 (около 125 ГБ) хватит пары карт по 96 ГБ, DeepSeek V4-Flash (около 160 ГБ весов) удобнее разместить на четырёх таких картах, а для DeepSeek V4-Pro на 1,6 трлн параметров (около 0,9 ТБ) нужен узел на 8 GPU с памятью HBM — B200, B300 или AMD MI355X; на восьми H200 он помещается впритык.
Затем выберите тип ускорителей. PCIe-карты — RTX PRO 6000 Blackwell Server Edition на 96 ГБ, H200 NVL на 141 ГБ — ставят в платформы 2U на 4 GPU или 4U на 8 GPU: такие системы проще разместить и расширять по одной карте. Модули SXM на платах NVIDIA HGX связаны через NVLink и NVSwitch, поэтому подходят для обучения и инференса крупных моделей, где важен обмен данными между GPU. Альтернатива на AMD — Instinct MI300X, MI325X и MI355X с памятью от 192 до 288 ГБ на ускоритель.
Проверьте инфраструктуру заранее: узел HGX на 8 GPU потребляет порядка 10 кВт, система на восьми PCIe-картах — около 6 кВт. Понадобятся стойка глубиной 1000–1200 мм, трёхфазное питание и расчёт охлаждения, а для кластера — сеть InfiniBand или Ethernet 400G на каждый ускоритель и быстрые NVMe под датасеты.
В разделе — платформы Supermicro, GIGABYTE, ASUS, ASRock Rack, Dell PowerEdge XE, HPE Cray XD, Huawei Atlas и системы NVIDIA DGX. Инженер подберёт конфигурацию под вашу модель и нагрузку, а перед отгрузкой мы соберём сервер, обновим прошивки и проверим его под нагрузкой — отчёт о тестировании приложим к заказу.
Для инференса в FP16 считайте около 2 ГБ на миллиард параметров, в FP8 — около 1 ГБ, плюс запас на KV-кэш и контекст. Многие новые модели — DeepSeek V4, gpt-oss, Kimi K3 — выпускают сразу в FP8 или FP4, тогда считайте по размеру опубликованных весов. Точный расчёт под вашу модель и число пользователей сделает инженер.
В HGX восемь модулей SXM соединены через NVLink и NVSwitch, поэтому GPU обмениваются данными быстрее, чем по шине PCIe. Серверы на PCIe-картах проще разместить, а карты в них можно добавлять и менять по одной.
Узел HGX на 8 GPU потребляет порядка 10 кВт, система на восьми PCIe-картах — около 6 кВт. В стойке нужны PDU на 32 А, обычно трёхфазные, и охлаждение под такую тепловую нагрузку.
Да. Опишите модель и нагрузку — инженер подберёт GPU, процессоры, память и сеть и пришлёт коммерческое предложение с вариантами.
Да, есть услуга развёртывания LLM под ключ: установим драйверы, CUDA или ROCm и сервер инференса.
От рабочих станций с одной картой до 8-GPU узлов HGX и стоек NVL72 — для обучения моделей, инференса LLM, RAG и рендеринга.
171 товар · цены для юрлиц с НДС и без НДСЦены не являются публичной офертой (ст. 437 ГК РФ) — стоимость оборудования и доставки уточняется по заявке.
Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) · Процессор (CPU): Intel Xeon · Видеокарта (GPU): NVIDIA H100 · Количество GPU, шт: 8
Арт. SB-000192Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) · Процессор (CPU): AMD EPYC · Видеокарта (GPU): NVIDIA A100 · Количество GPU, шт: 3
Арт. SB-000161Основная задача: Инференс / Дообучение моделей / RAG-системы / Анализ данных / Визуализация и рендеринг · Видеокарта (GPU): GIGABYTE Radeon AI PRO R9700 AI TOP · Количество GPU, шт: 4 · Общий объем видеопамяти (VRAM), ГБ: 128
Арт. SB-000138Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) / Визуализация и рендеринг · Процессор (CPU): Intel Xeon · Видеокарта (GPU): AMD Radeon Instinct MI100 · Количество GPU,
Арт. SB-000139Закупаете партию для ИИ-фермы? Подготовим КП с ценой за объём
Пришлите список моделей и количество — ответим коммерческим предложением с НДС и сроками поставки.Основная задача: Инференс / Дообучение моделей / RAG-системы · Процессор (CPU): Intel Xeon · Видеокарта (GPU): NVIDIA Tesla V100 · Количество GPU, шт: 6
Арт. SB-000140Основная задача: Инференс / Дообучение моделей / RAG-системы / Анализ данных / Визуализация и рендеринг · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): GIGABYTE Radeon AI PRO R9700 AI TOP · Количество GPU, шт: 6
Арт. SB-000142Основная задача: Инференс / Дообучение моделей / RAG-системы · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): NVIDIA Tesla P100 · Количество GPU, шт: 6
Арт. SB-000143Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) / Визуализация и рендеринг · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): AMD Radeon Instinct MI100 · Колич
Арт. SB-000148Основная задача: Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): AMD Radeon Instinct MI50 · Количество GPU, шт: 4
Арт. SB-000149Основная задача: Инференс / Дообучение моделей / RAG-системы / Анализ данных / Визуализация и рендеринг · Процессор (CPU): AMD EPYC · Видеокарта (GPU): GIGABYTE Radeon AI PRO R9700 AI TOP · Количество GPU, шт: 4
Арт. SB-000150Основная задача: Обучение моделей / Инференс / Дообучение моделей / Визуализация и рендеринг · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): AMD Radeon Pro WX8200 · Количество GPU, шт: 4
Арт. SB-000151Основная задача: Инференс / Дообучение моделей · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): NVIDIA Tesla P100 · Количество GPU, шт: 4
Арт. SB-000152Основная задача: Инференс / Дообучение моделей / RAG-системы · Процессор (CPU): Intel Xeon E5-series · Видеокарта (GPU): NVIDIA Tesla V100 · Количество GPU, шт: 4
Арт. SB-000153Основная задача: Инференс / Дообучение моделей / RAG-системы · Процессор (CPU): AMD EPYC · Видеокарта (GPU): NVIDIA Tesla V100 · Количество GPU, шт: 3
Арт. SB-000160Начните с задачи: модель, точность и число одновременных пользователей определяют объём видеопамяти, а он — количество и тип ускорителей. Ориентир для инференса: в FP16 модель занимает около 2 ГБ на миллиард параметров, в FP8 — около 1 ГБ, в 4-битных форматах — около 0,6 ГБ, плюс запас под KV-кэш и контекст; у MoE-моделей считают все параметры, а не только активные. Qwen3.5-122B-A10B в FP8 (около 125 ГБ) хватит пары карт по 96 ГБ, DeepSeek V4-Flash (около 160 ГБ весов) удобнее разместить на четырёх таких картах, а для DeepSeek V4-Pro на 1,6 трлн параметров (около 0,9 ТБ) нужен узел на 8 GPU с памятью HBM — B200, B300 или AMD MI355X; на восьми H200 он помещается впритык.
Затем выберите тип ускорителей. PCIe-карты — RTX PRO 6000 Blackwell Server Edition на 96 ГБ, H200 NVL на 141 ГБ — ставят в платформы 2U на 4 GPU или 4U на 8 GPU: такие системы проще разместить и расширять по одной карте. Модули SXM на платах NVIDIA HGX связаны через NVLink и NVSwitch, поэтому подходят для обучения и инференса крупных моделей, где важен обмен данными между GPU. Альтернатива на AMD — Instinct MI300X, MI325X и MI355X с памятью от 192 до 288 ГБ на ускоритель.
Проверьте инфраструктуру заранее: узел HGX на 8 GPU потребляет порядка 10 кВт, система на восьми PCIe-картах — около 6 кВт. Понадобятся стойка глубиной 1000–1200 мм, трёхфазное питание и расчёт охлаждения, а для кластера — сеть InfiniBand или Ethernet 400G на каждый ускоритель и быстрые NVMe под датасеты.
В разделе — платформы Supermicro, GIGABYTE, ASUS, ASRock Rack, Dell PowerEdge XE, HPE Cray XD, Huawei Atlas и системы NVIDIA DGX. Инженер подберёт конфигурацию под вашу модель и нагрузку, а перед отгрузкой мы соберём сервер, обновим прошивки и проверим его под нагрузкой — отчёт о тестировании приложим к заказу.
Для инференса в FP16 считайте около 2 ГБ на миллиард параметров, в FP8 — около 1 ГБ, плюс запас на KV-кэш и контекст. Многие новые модели — DeepSeek V4, gpt-oss, Kimi K3 — выпускают сразу в FP8 или FP4, тогда считайте по размеру опубликованных весов. Точный расчёт под вашу модель и число пользователей сделает инженер.
В HGX восемь модулей SXM соединены через NVLink и NVSwitch, поэтому GPU обмениваются данными быстрее, чем по шине PCIe. Серверы на PCIe-картах проще разместить, а карты в них можно добавлять и менять по одной.
Узел HGX на 8 GPU потребляет порядка 10 кВт, система на восьми PCIe-картах — около 6 кВт. В стойке нужны PDU на 32 А, обычно трёхфазные, и охлаждение под такую тепловую нагрузку.
Да. Опишите модель и нагрузку — инженер подберёт GPU, процессоры, память и сеть и пришлёт коммерческое предложение с вариантами.
Да, есть услуга развёртывания LLM под ключ: установим драйверы, CUDA или ROCm и сервер инференса.