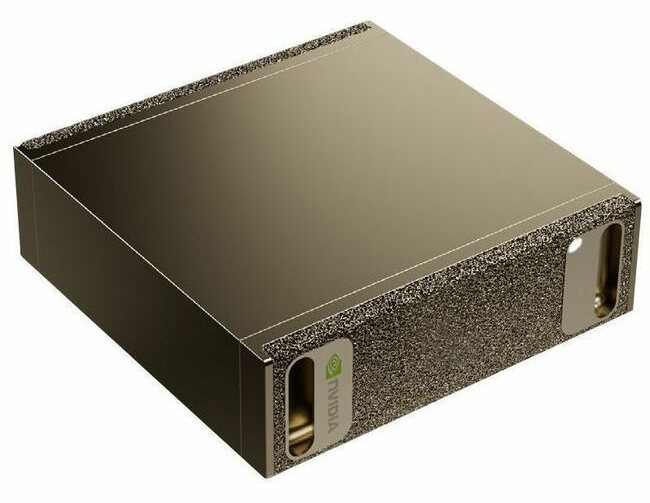
1 × DGX Spark
Разработка и прототипы, один пользователь- ФорматНастольный, 150 × 150 мм
- ТочностьNVFP4 / FP8
- СвязкаДо четырёх Spark через ConnectX-7
Видеопамять128 ГБ
от 1 085 200 ₽с НДС
Готовые конфигурации для Qwen3.5-122B-A10B, gpt-oss-120b и Mistral Small 4 — MoE-моделей, которые заменили Llama 3.3 70B и Qwen2.5-72B: от настольного DGX Spark до сервера на 4 × RTX PRO 6000. Посчитаем видеопамять под ваш контекст и число пользователей.
| Точность | Веса модели | С контекстом 10 × 32K | Подойдёт |
|---|---|---|---|
| BF16 | ~245 ГБ | ~280 ГБ | 4 × RTX PRO 6000 (384 ГБ) |
| FP8 | ~125 ГБ | ~150 ГБ | 2 × RTX PRO 6000 (192 ГБ) или 2 × H100 NVL (188 ГБ) |
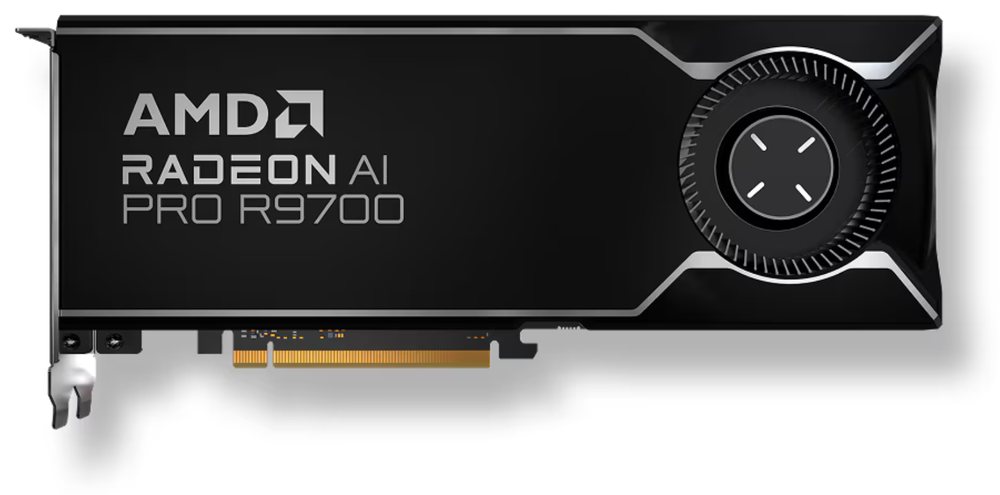
| 4 бита | ~68–74 ГБ | ~85–90 ГБ | DGX Spark или 4 × Radeon AI PRO R9700 (128 ГБ); одна RTX PRO 6000 — впритык |
| MXFP4, gpt-oss-120b | ~63 ГБ | ~83 ГБ | H100 NVL (94 ГБ), RTX PRO 6000 (96 ГБ) или DGX Spark |
Строки BF16, FP8 и 4 бита — для Qwen3.5-122B-A10B: у MoE в памяти держат все 122 млрд параметров, хотя на токен работают 10 млрд. Контекст — 10 одновременных запросов по 32K токенов: у этой модели KV-кэш 24 КБ на токен, всего около 8 ГБ, плюс ~10% на среду запуска. Для сравнения: у плотной Llama 3.3 70B кэш 320 КБ на токен, те же 10 × 32K заняли бы ~107 ГБ сверх весов. Mistral Small 4 и Nemotron 3 Super в NVFP4 — 65–70 ГБ весов, как строка «4 бита».
Скорость генерации замеряем на нашем стенде для вашей модели и длины контекста.
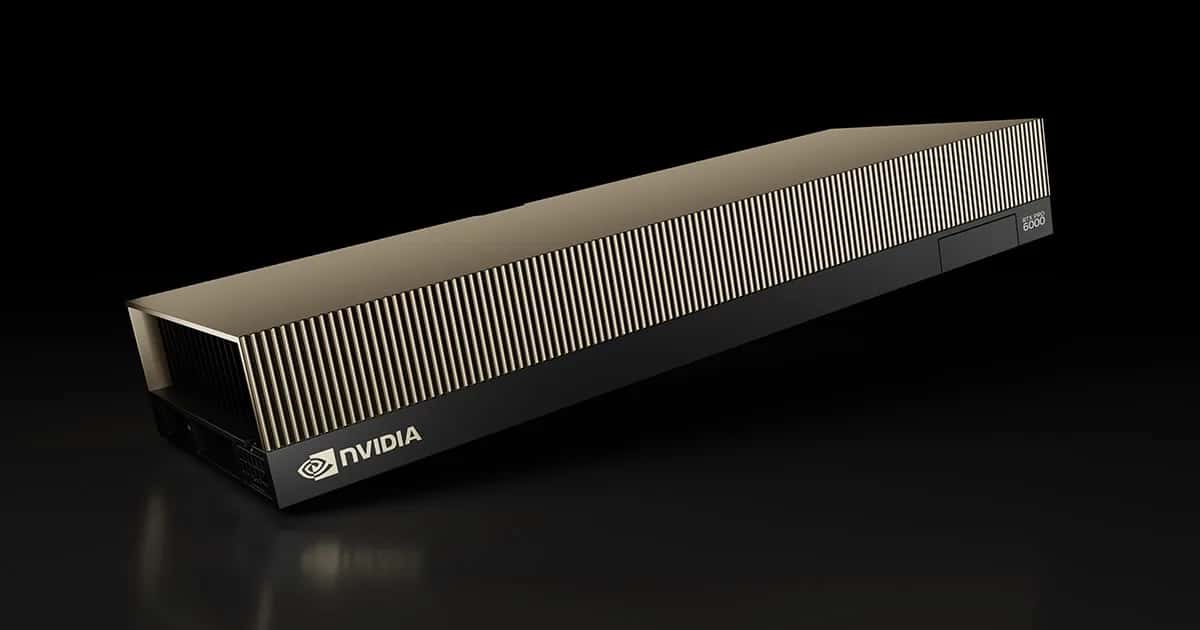
Количество видеовыходов: 4 · Видеовыходы: DisplayPort · Объем видеопамяти: 96GB · Разрядность шины памяти: 512 bit
P/N: 900-2G153-0000-000 / 900-2G153-0210-300 / 699-2G153-0210-300 / RR-NVA-PG153A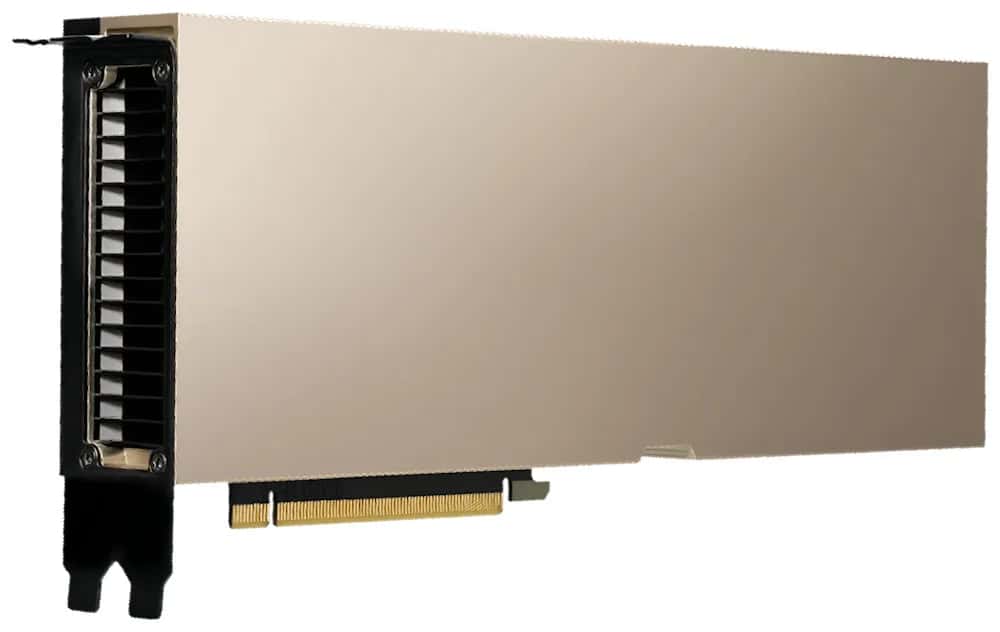
Количество видеовыходов: 0 · Видеовыходы: Нет · Объем видеопамяти: 141GB · Разрядность шины памяти: 6144 bit
P/N: 900-21010-0040-000 / GPU-NVH200NVL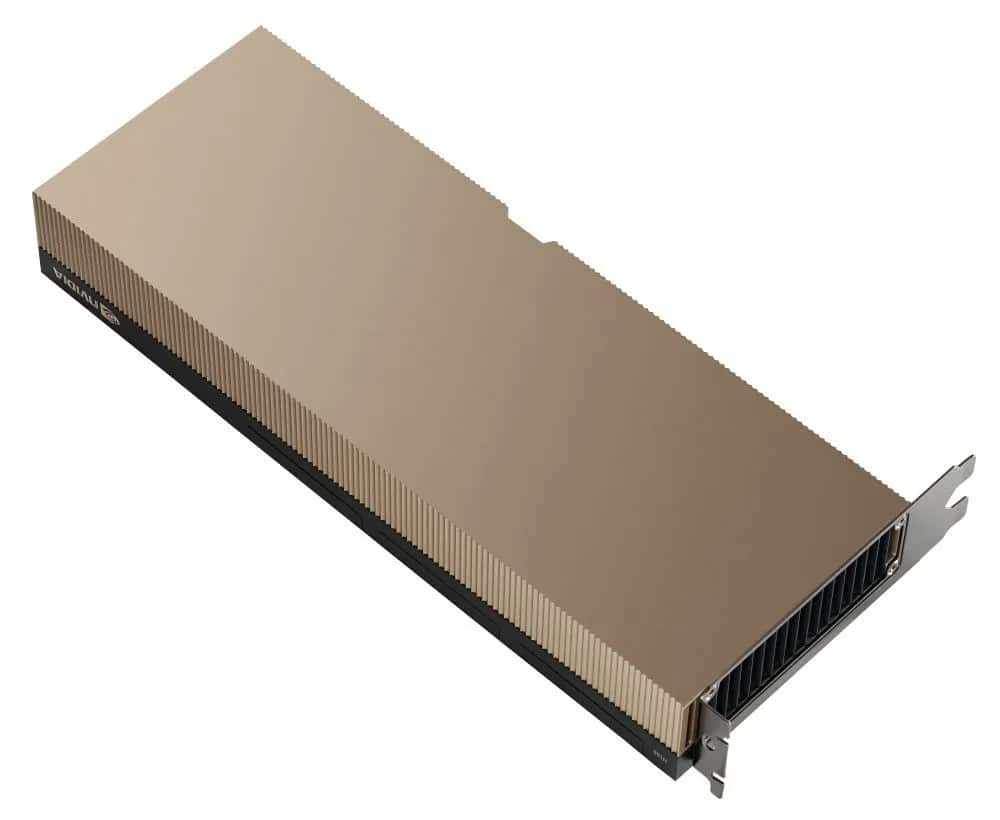
Количество видеовыходов: 0 · Видеовыходы: Нет · Объем видеопамяти: 94GB · Разрядность шины памяти: 5120 bit
P/N: 900-21010-0020-000 / 699-21010-0210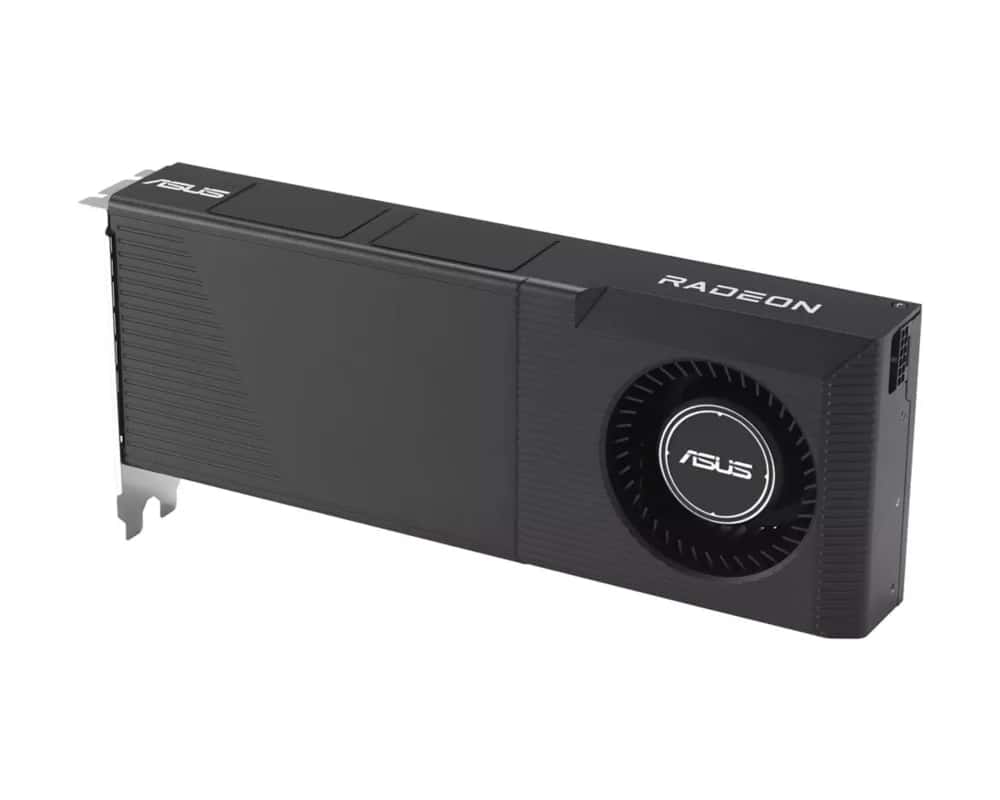
Количество видеовыходов: 4 · Видеовыходы: HDMI / DisplayPort · Объем видеопамяти: 32GB · Разрядность шины памяти: 256 bit
P/N: TURBO-AI-PRO-R9700-32GПосчитаем видеопамять, подберём конфигурацию и пришлём КП с ценой и сроком сборки.
Для Qwen3.5-122B-A10B или gpt-oss-120b в 4 битах — да: веса занимают 63–74 ГБ, на контекст остаётся 15–20 ГБ, этого хватит нескольким пользователям. Для FP8 или десятка пользователей с длинным контекстом нужны две карты.
Это MoE: в памяти лежат все 122 млрд параметров, но на каждый токен считаются только 10 млрд (у gpt-oss-120b — 5,1 млрд, у Mistral Small 4 — 6,5 млрд). Видеопамяти нужно по полному размеру, а скорость генерации определяют активные параметры.
Qwen3.8-27B, Gemma 4 31B или gpt-oss-20b в 4 битах занимают 13–18 ГБ: хватит одной RTX PRO 4000 на 24 ГБ. Для FP8 и нескольких пользователей — карта на 48–96 ГБ: RTX PRO 5000, L40S или RTX PRO 6000.
DeepSeek-V4-Flash (284 млрд параметров, веса ~160 ГБ в FP4 и FP8) — 4 × RTX PRO 6000 или 2 × H200 NVL (поддержку FP4 на Hopper проверим в движке); на 2 × RTX PRO 6000 — только с коротким контекстом. Новая V4.1-Flash (763 млрд параметров, веса ~0,51 ТБ в FP8 и INT8) помещается в 8 × RTX PRO 6000 (768 ГБ) или 8 × H200; на 4 × H200 NVL — впритык. DeepSeek-V4-Pro (1,6 трлн, ~0,9 ТБ) — 8 × B200, B300 или MI355X.
Spark — для разработки и одного-двух пользователей: 128 ГБ общей памяти, но 273 ГБ/с. Для команды — сервер: у RTX PRO 6000 около 1,6 ТБ/с на каждую карту, и карты можно добавлять. Подробнее — в сравнении DGX Spark и RTX 4090.
Да, через ROCm с vLLM или llama.cpp. У Radeon AI PRO R9700 нет аппаратного FP4, поэтому веса MXFP4 и NVFP4 запускаются не в каждом движке — чаще берём GGUF-квантование. Перед продажей проверим вашу связку модели и фреймворка.
Да: установим драйверы, фреймворк и модель, настроим доступ по API. Условия — в услугах.
Готовые конфигурации для Qwen3.5-122B-A10B, gpt-oss-120b и Mistral Small 4 — MoE-моделей, которые заменили Llama 3.3 70B и Qwen2.5-72B: от настольного DGX Spark до сервера на 4 × RTX PRO 6000. Посчитаем видеопамять под ваш контекст и число пользователей.
| Точность | Веса модели | С контекстом 10 × 32K | Подойдёт |
|---|---|---|---|
| BF16 | ~245 ГБ | ~280 ГБ | 4 × RTX PRO 6000 (384 ГБ) |
| FP8 | ~125 ГБ | ~150 ГБ | 2 × RTX PRO 6000 (192 ГБ) или 2 × H100 NVL (188 ГБ) |
| 4 бита | ~68–74 ГБ | ~85–90 ГБ | DGX Spark или 4 × Radeon AI PRO R9700 (128 ГБ); одна RTX PRO 6000 — впритык |
| MXFP4, gpt-oss-120b | ~63 ГБ | ~83 ГБ | H100 NVL (94 ГБ), RTX PRO 6000 (96 ГБ) или DGX Spark |
Строки BF16, FP8 и 4 бита — для Qwen3.5-122B-A10B: у MoE в памяти держат все 122 млрд параметров, хотя на токен работают 10 млрд. Контекст — 10 одновременных запросов по 32K токенов: у этой модели KV-кэш 24 КБ на токен, всего около 8 ГБ, плюс ~10% на среду запуска. Для сравнения: у плотной Llama 3.3 70B кэш 320 КБ на токен, те же 10 × 32K заняли бы ~107 ГБ сверх весов. Mistral Small 4 и Nemotron 3 Super в NVFP4 — 65–70 ГБ весов, как строка «4 бита».
Скорость генерации замеряем на нашем стенде для вашей модели и длины контекста.
Количество видеовыходов: 4 · Видеовыходы: DisplayPort · Объем видеопамяти: 96GB · Разрядность шины памяти: 512 bit
P/N: 900-2G153-0000-000 / 900-2G153-0210-300 / 699-2G153-0210-300 / RR-NVA-PG153AКоличество видеовыходов: 0 · Видеовыходы: Нет · Объем видеопамяти: 141GB · Разрядность шины памяти: 6144 bit
P/N: 900-21010-0040-000 / GPU-NVH200NVLКоличество видеовыходов: 0 · Видеовыходы: Нет · Объем видеопамяти: 94GB · Разрядность шины памяти: 5120 bit
P/N: 900-21010-0020-000 / 699-21010-0210Количество видеовыходов: 4 · Видеовыходы: HDMI / DisplayPort · Объем видеопамяти: 32GB · Разрядность шины памяти: 256 bit
P/N: TURBO-AI-PRO-R9700-32GПосчитаем видеопамять, подберём конфигурацию и пришлём КП с ценой и сроком сборки.
Для Qwen3.5-122B-A10B или gpt-oss-120b в 4 битах — да: веса занимают 63–74 ГБ, на контекст остаётся 15–20 ГБ, этого хватит нескольким пользователям. Для FP8 или десятка пользователей с длинным контекстом нужны две карты.
Это MoE: в памяти лежат все 122 млрд параметров, но на каждый токен считаются только 10 млрд (у gpt-oss-120b — 5,1 млрд, у Mistral Small 4 — 6,5 млрд). Видеопамяти нужно по полному размеру, а скорость генерации определяют активные параметры.
Qwen3.8-27B, Gemma 4 31B или gpt-oss-20b в 4 битах занимают 13–18 ГБ: хватит одной RTX PRO 4000 на 24 ГБ. Для FP8 и нескольких пользователей — карта на 48–96 ГБ: RTX PRO 5000, L40S или RTX PRO 6000.
DeepSeek-V4-Flash (284 млрд параметров, веса ~160 ГБ в FP4 и FP8) — 4 × RTX PRO 6000 или 2 × H200 NVL (поддержку FP4 на Hopper проверим в движке); на 2 × RTX PRO 6000 — только с коротким контекстом. Новая V4.1-Flash (763 млрд параметров, веса ~0,51 ТБ в FP8 и INT8) помещается в 8 × RTX PRO 6000 (768 ГБ) или 8 × H200; на 4 × H200 NVL — впритык. DeepSeek-V4-Pro (1,6 трлн, ~0,9 ТБ) — 8 × B200, B300 или MI355X.
Spark — для разработки и одного-двух пользователей: 128 ГБ общей памяти, но 273 ГБ/с. Для команды — сервер: у RTX PRO 6000 около 1,6 ТБ/с на каждую карту, и карты можно добавлять. Подробнее — в сравнении DGX Spark и RTX 4090.
Да, через ROCm с vLLM или llama.cpp. У Radeon AI PRO R9700 нет аппаратного FP4, поэтому веса MXFP4 и NVFP4 запускаются не в каждом движке — чаще берём GGUF-квантование. Перед продажей проверим вашу связку модели и фреймворка.
Да: установим драйверы, фреймворк и модель, настроим доступ по API. Условия — в услугах.