DGX Spark или RTX 4090 для локальных LLM
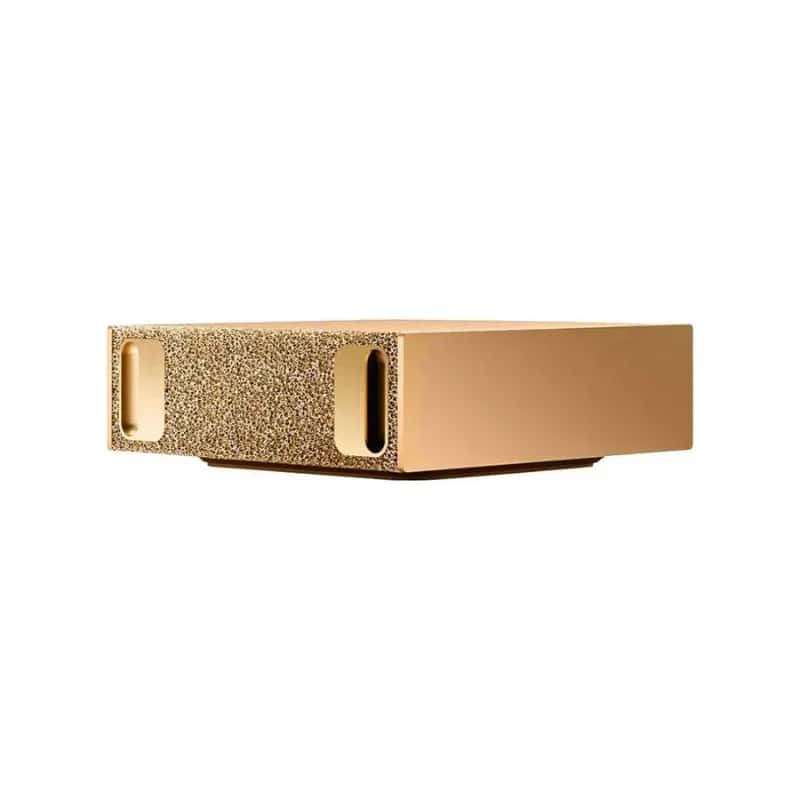
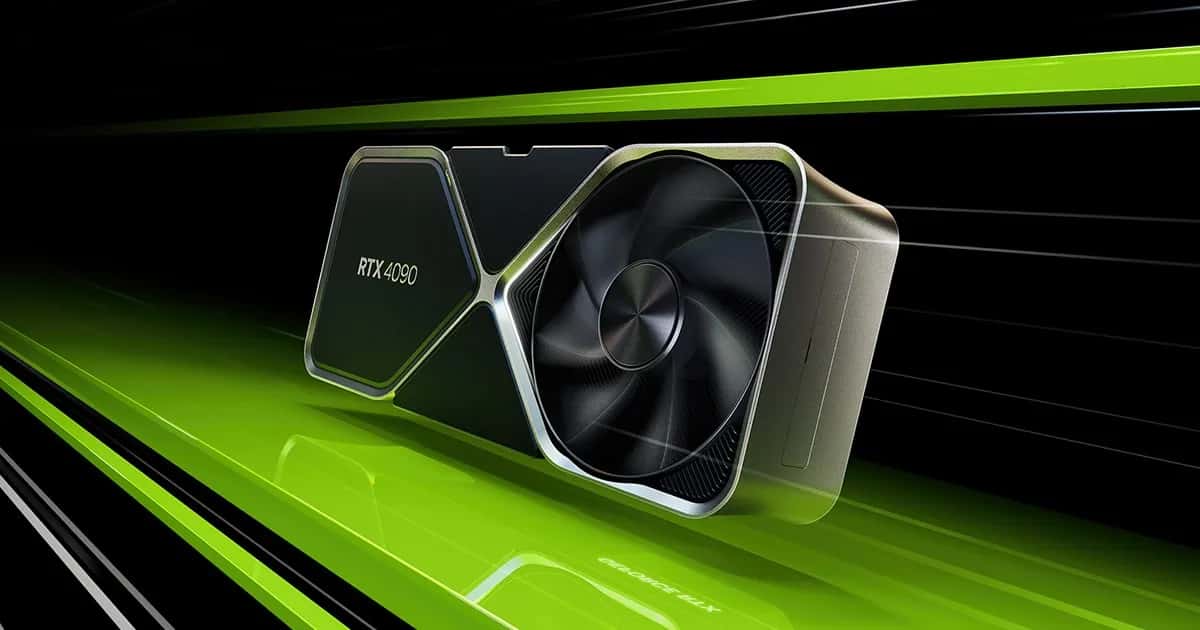
DGX Spark — когда модель не помещается в 24 ГБ. RTX 4090 — когда помещается и важна скорость.
У Spark в пять с лишним раз больше памяти для модели, у RTX 4090 — почти в четыре раза быстрее память. Поэтому выбор зависит от размера модели.
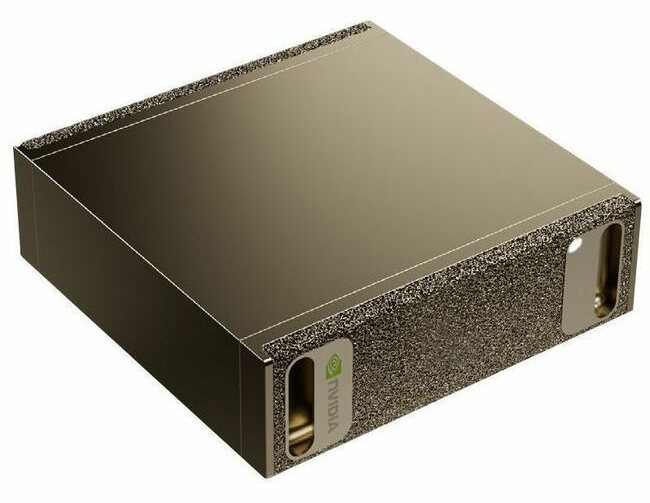
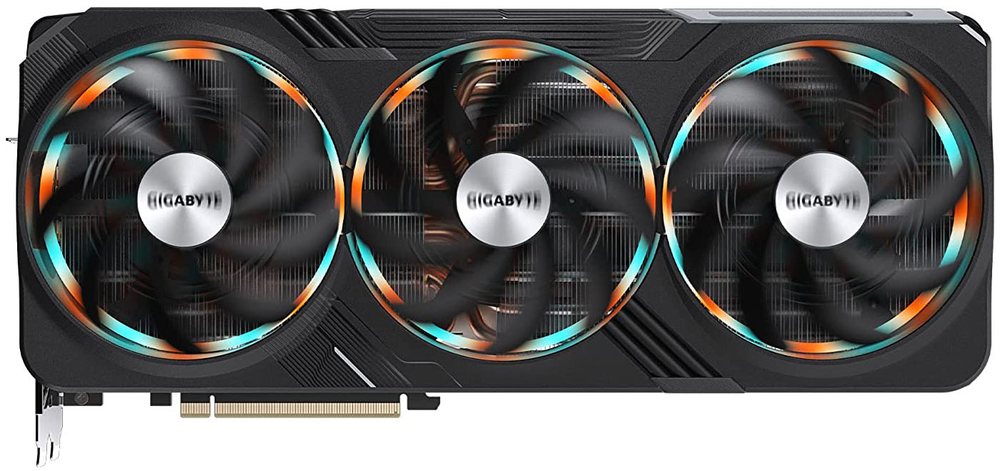
Характеристики
| Параметр | NVIDIA DGX Spark | GeForce RTX 4090 |
|---|---|---|
| Тип | Готовая настольная система | Видеокарта, нужен компьютер |
| Память для модели | 128 ГБ LPDDR5x, общая с процессором | 24 ГБ GDDR6X |
| Пропускная способность | 273 ГБ/с | 1008 ГБ/с |
| Архитектура | Grace Blackwell (GB10), процессор Arm | Ada Lovelace, 2022 год |
| Аппаратный FP4 | Да | Нет, только FP8 |
| Энергопотребление | Блок питания 240 Вт на всю систему | 450 Вт только карта |
| Связка нескольких | До четырёх систем через ConnectX-7 | Несколько карт по PCIe, без NVLink |
| ПО | DGX OS на базе Ubuntu, CUDA | CUDA, Windows или Linux |
Что выбрать
- модель не помещается в 24 ГБ: gpt-oss-120b, Qwen3.5-122B-A10B, Nemotron 3 Super целиком помещаются в 128 ГБ
- важны компактность и тишина на рабочем месте
- нужна та же программная среда, что на серверах NVIDIA
- модели помещаются в 24 ГБ: Qwen3.8-27B или Gemma 4 31B в 4 битах, gpt-oss-20b
- важна скорость генерации: память быстрее почти в 4 раза
- уже есть рабочая станция, куда можно поставить карту
Почему память решает
Чтобы модель работала быстро, её веса должны целиком поместиться в память, и ещё нужно место под контекст. В 24 ГБ помещаются плотные модели примерно до 30B в 4 битах: Qwen3.8-27B занимает около 16 ГБ, Gemma 4 31B — около 18 ГБ. У гибридных моделей вроде Qwen3.6-27B контекст обходится дёшево: около 64 КБ на токен, 32 тысячи токенов — около 2 ГБ.
В 128 ГБ DGX Spark помещаются MoE-модели на 120B: gpt-oss-120b в родном формате MXFP4 занимает чуть больше 60 ГБ, Qwen3.5-122B-A10B в 4 битах — около 68 ГБ. На одной RTX 4090 они целиком не помещаются: часть весов придётся держать в оперативной памяти компьютера, а это в разы медленнее.
Когда модель помещается в обе системы, быстрее отвечает та, у которой быстрее память: на каждый токен GPU заново читает веса. Здесь у RTX 4090 преимущество — 1008 ГБ/с против 273 ГБ/с.
Почему для Spark берут MoE-модели
У MoE-модели на каждый токен читаются только активные параметры. У gpt-oss-120b их 5,1 млрд из 117 млрд, поэтому теоретический потолок на DGX Spark — около 100 токенов в секунду на один поток (273 ГБ/с ÷ ~2,7 ГБ на токен); на практике меньше. Плотная модель на 70B в 8 битах на том же Spark упрётся в потолок около 4 токенов в секунду.
Что с командой и продакшном
Обе системы рассчитаны на одного пользователя или небольшую группу. Для сервиса на десятки пользователей нужен сервер с несколькими GPU и запасом памяти под контекст каждого пользователя — смотрите конфигурации серверов для LLM на 70–130B.