NVIDIA DGX Spark 128 ГБ для локальных LLM
Разбираем, что даёт GB10 со 128 ГБ общей памяти и когда стоит выбрать стоечный GPU-сервер для локальных LLM, RAG или дообучения.
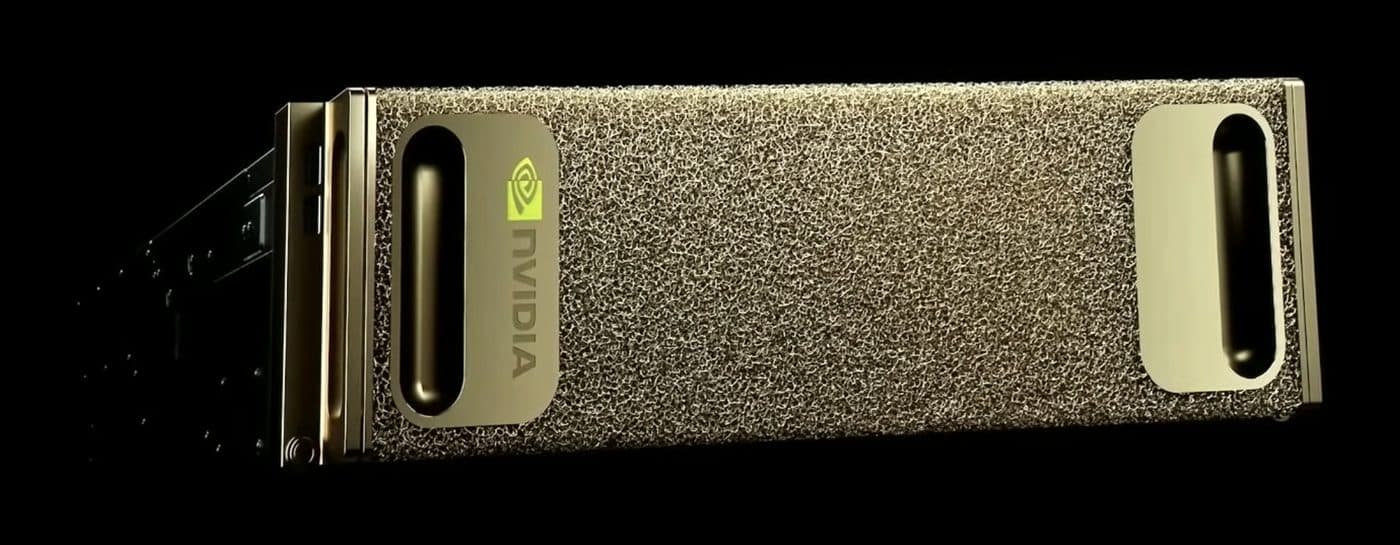
NVIDIA DGX Spark с 128 ГБ общей памяти подходит разработчику, которому нужно запускать крупные языковые модели на рабочем столе. На нём удобно собирать прототипы, тестировать RAG на внутренних документах и обучать адаптеры. Если модель должна отвечать сотрудникам в часы пик, выбор между Spark и GPU-сервером зависит от числа одновременных запросов, длины контекста и допустимого времени ответа.
Что дают GB10 и 128 ГБ общей памяти
В NVIDIA GB10 Grace Blackwell работают 20-ядерный процессор Arm и встроенный GPU Blackwell. Они обращаются к одному пулу LPDDR5X. Операционная система, веса моделей, кэш контекста, временные буферы и приложения делят доступный объём. При выборе конфигурации имеет смысл считать пиковое потребление всей системы, включая эмбеддинги и сервис поиска, если они работают на том же устройстве. Существуют и версии DGX Spark на 64 ГБ. Расчёты ниже относятся к конфигурации на 128 ГБ. При покупке сверяйте объём памяти конкретной комплектации.
| Характеристика DGX Spark 128 ГБ | Что учитывать |
|---|---|
| NVIDIA GB10, Arm64 и GPU Blackwell | Для готовых контейнеров и библиотек требуется совместимость с Linux ARM64 и версией CUDA |
| 128 ГБ общей LPDDR5X, 273 ГБ/с | Одна модель может занять значительную часть пула. При генерации важна также скорость чтения памяти |
| До 1 PFLOP FP4 | Теоретический пик с разреженностью. Для оценки скорости ответа нужен тест конкретной модели |
| NVMe M.2 на 1 или 4 ТБ | На диске хранятся модели, контейнеры, наборы данных и контрольные точки |
| 10 GbE и ConnectX-7 | Первый интерфейс подходит для локального доступа к сервису. ConnectX-7 используется для высокоскоростного соединения систем |
Характеристики приведены по документации производителя. Руководство NVIDIA DGX Spark, спецификация NVIDIA.
Какие LLM можно запустить на NVIDIA DGX Spark
Для начала возьмите фактический размер файлов модели в нужном формате. Ориентир для плотной модели на 70 млрд параметров — примерно 140 ГБ только под веса в BF16, 70 ГБ при 8 битах и 35 ГБ при 4 битах. Это десятичные ГБ и расчёт по числу параметров. Реальный размер зависит от формата, коэффициентов квантования и тензоров, сохранённых с другой точностью. Дополнительно нужны память под контекст, рабочие буферы движка и запас для системы. Гайд по выбору GPU для LLM, что такое KV-кэш.
Для версии на 128 ГБ NVIDIA заявляет инференс моделей до 200 млрд параметров. Даже при 4 битах теоретический минимум для весов модели на 200 млрд составляет около 100 ГБ. Проверьте, сколько останется для нужной длины контекста и параллельных сессий. Для первой проверки можно взять сценарий NVIDIA для gpt-oss-120b в MXFP4 и зафиксировать формат весов, версию движка и максимальный контекст. Рецепты TensorRT-LLM для DGX Spark, карточка модели gpt-oss-120b.
У модели, которая помещается в память, остаётся вопрос скорости. При последовательной генерации одним запросом плотная модель повторно считывает большой объём весов на каждом шаге. При длинном входе дополнительно растёт время обработки промпта до первого токена. Замерьте эти две стадии отдельно. Запуск короткой команды и работа с десятками страниц в контексте могут давать разные результаты на одном устройстве.
Кому подходит DGX Spark
Разработчику LLM-приложений
Для работы над интерфейсом чата, интеграцией модели или оценкой качества ответов можно держать модель и API на Spark, а писать код с основного ноутбука. Для личного чата NVIDIA приводит пример с Ollama и Open WebUI. Если приложению нужен локальный API, у NVIDIA есть отдельное руководство по vLLM. Зафиксируйте версии контейнера и модели, чтобы воспроизвести тот же эксперимент при переносе на сервер. Руководства NVIDIA по запуску моделей, vLLM на одном DGX Spark.
Команде, которая проверяет RAG на своих документах
Для пилота чата по базе знаний соберите небольшой набор типовых вопросов с эталонными ссылками на документы. Измерьте, как часто поиск находит нужный фрагмент и правильно ли модель ссылается на него в ответе. Проверьте повторно после добавления новых файлов, когда индексатор и генерация работают одновременно. Если документы должны оставаться в локальном контуре, проверьте настройки распознавания файлов, эмбеддингов, векторного индекса и внешних интеграций. Пример RAG от NVIDIA, что такое RAG.
Инженеру, который дообучает готовую модель
Начните с LoRA или QLoRA на небольшом наборе примеров. Эти методы обновляют компактный набор параметров адаптера. В рецептах NeMo NVIDIA указывает модели примерно от 1 до 70 млрд параметров, включая режимы параметроэффективного дообучения. Для конкретного запуска сначала проверьте пиковую память на коротком прогоне. Длина последовательности, размер микробатча, активации и состояние оптимизатора влияют на требования обучения. Выделите независимый набор данных для финальной оценки качества адаптера. Руководство NVIDIA по NeMo AutoModel, пример LoRA в LLaMA Factory.
Если на той же машине будут храниться несколько чекпойнтов, контейнеры и наборы данных, сравните комплектации по объёму SSD. В каталоге есть ASUS Ascent GX10 с GB10, 128 ГБ общей памяти и накопителем на 4 ТБ. Линейка ASUS Ascent GX10.
Как проверить свою модель на DGX Spark
- Выберите чекпойнт и движок. Например, для gpt-oss-120b можно начать с рецепта NVIDIA для TensorRT-LLM с весами в MXFP4. Если продукт уже использует другой движок, проверьте его совместимость с моделью, GB10 и форматом весов.
- Задайте длину контекста. Возьмите типичный запрос и один длинный из вашей работы. Учтите инструкции, историю диалога, фрагменты документов и токены, которые модель добавит в ответ.
- Посмотрите на расход памяти. Запишите загрузку после запуска модели и пик на длинном запросе. Повторите тест с сопутствующими сервисами. Для RAG это может быть процесс эмбеддинга, индексация файлов и поиск.
- Проверьте требования к скорости. Замерьте время до первого токена и полный ответ. Для командного пилота повторите прогон с несколькими одновременными запросами и посмотрите, появляется ли очередь.
Сохраните рядом с результатами название версии модели, параметры контекста и версии контейнера и драйвера. Если эти же запросы предстоит перенести на стоечный сервер, готовый набор тестов позволит сравнить две машины при одинаковых условиях.
DGX Spark или стоечный GPU-сервер
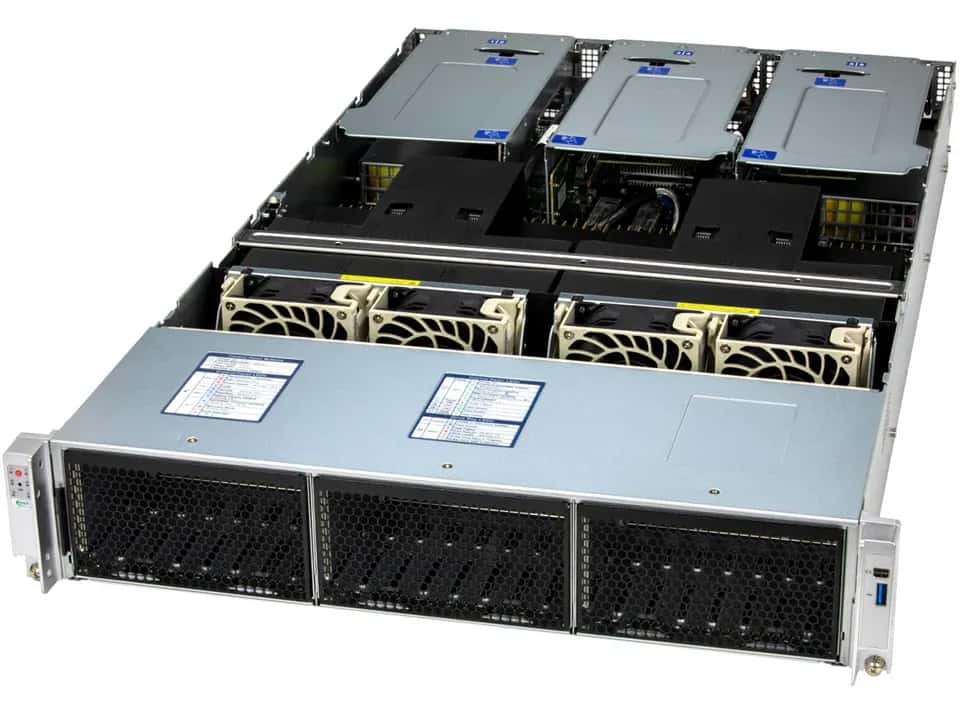
Для сравнения возьмём две реальные конфигурации. DGX Spark рассчитан на настольное размещение. Supermicro SYS-222C-TN в конфигурации из каталога занимает 2U, оснащается двумя Xeon 6745P и двумя RTX PRO 6000 Blackwell Server Edition по 96 ГБ. У каждой карты своя GDDR7 с пропускной способностью 1 597 ГБ/с по спецификации NVIDIA. У Spark 128 ГБ доступны из одного пула с пропускной способностью 273 ГБ/с. При распределении модели между двумя серверными GPU движок отдельно размещает части модели и обменивается данными между картами. Спецификация Supermicro SYS-222C-TN, спецификация NVIDIA RTX PRO 6000 Blackwell Server Edition.
| Критерий | DGX Spark 128 ГБ | Supermicro SYS-222C-TN с 2 × RTX PRO 6000 BSE |
|---|---|---|
| Память | Общая для CPU, GPU и приложений | По 96 ГБ GDDR7 на каждом GPU, отдельно от системной RAM |
| Развёртывание ПО | DGX OS на Arm64, образы linux/arm64 | Платформа Xeon x86-64, образы linux/amd64 |
| Размещение | Рабочий стол, внешнее питание | Стойка 2U с серверным питанием и охлаждением |
| Типичная задача | Личные эксперименты, прототип, пилот RAG | Общий сервис, параллельные запросы, несколько моделей или реплик |
Для команды соберите запросы с типичной и максимальной длиной контекста. Прогоните их сначала по одному, затем с ожидаемым числом одновременных пользователей. Зафиксируйте время до первого токена, скорость генерации, 95-й процентиль задержки всего ответа, очередь и пиковую память. Задайте допустимый порог задержки заранее. По этим замерам можно решить, хватит ли Spark для пилота и какую серверную конфигурацию закладывать под рабочую нагрузку.
Если у вас уже есть модель, укажите её название, формат весов, длину контекста и число одновременных запросов. Для подбора конфигурации можно начать с решения СерверБокс для моделей на 70–130 млрд параметров. Сервер для LLM 70–130B, конфигуратор GPU-сервера. Если рассматриваете стоечную сборку, сравните платформы AMD EPYC и Intel Xeon.
Товары из статьи
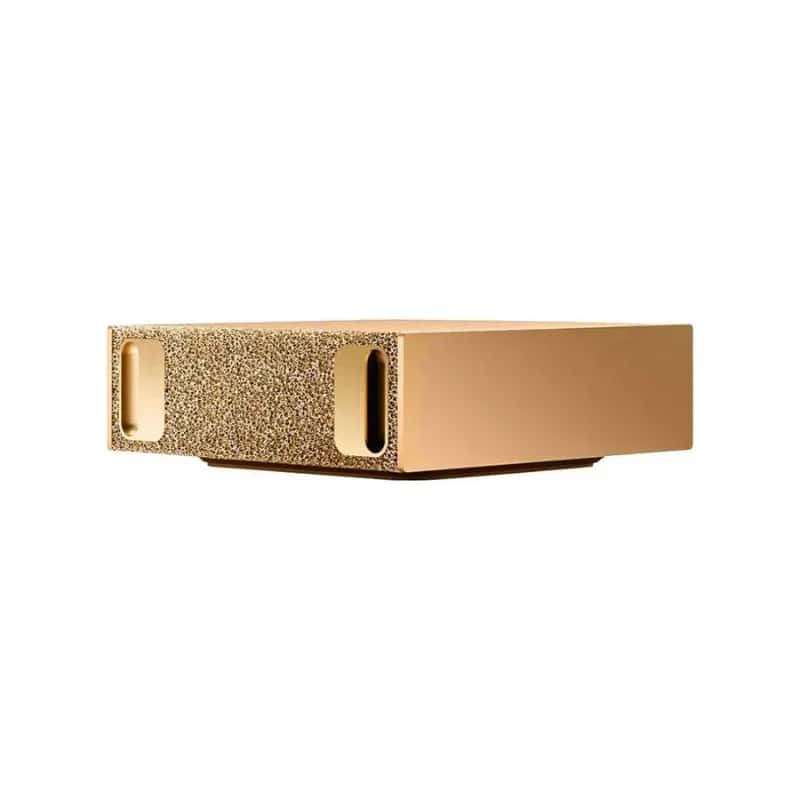
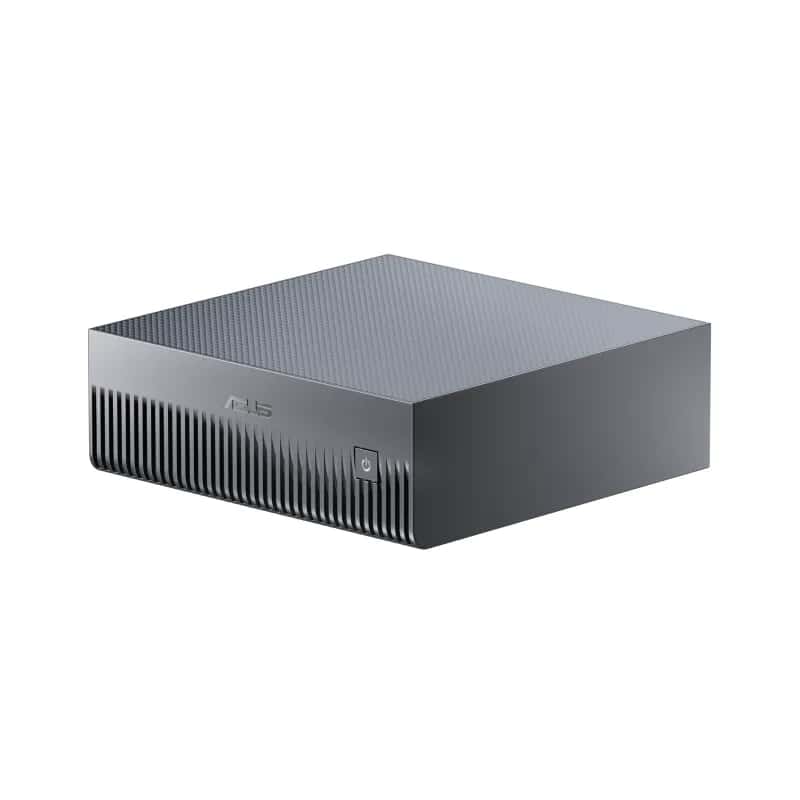
AI-суперкомпьютер ASUS Ascent GX10 (GB10 Grace Superchip, ARM v9.2-A (GB10), RAM 128GB, SSD 4TB)
Частые вопросы о DGX Spark
Можно ли объединить два DGX Spark по 128 ГБ?
Да. NVIDIA описывает прямое соединение по ConnectX-7 с совместимым QSFP-кабелем. Два узла дают суммарно 256 ГБ, с отдельным пулом по 128 ГБ на каждом. Для запуска одной модели на них нужен движок с поддержкой её распределения, например vLLM с подходящим рецептом. Проверьте задержку обмена на нужном контексте и числе запросов. Инструкция по соединению DGX Spark, vLLM для кластера DGX Spark.
Запустится ли мой Docker-образ на Spark?
Проверьте, что у образа есть вариант linux/arm64, а версии CUDA, PyTorch и сторонних CUDA-расширений поддерживают GB10. Если контейнер опубликован только для linux/amd64, понадобится сборка для Arm64 или подходящая замена. Проверьте это на небольшом запуске, включая все нативные зависимости. Руководство по переносу ПО на NVIDIA DGX Spark.
Можно ли сравнить Spark с компьютером на RTX 4090?
Да. В таком сравнении важны объём памяти, скорость обработки длинного промпта и генерация после него. Сначала определите, помещаются ли нужные веса и контекст в 24 ГБ VRAM RTX 4090. Тестируйте обе машины на одном чекпойнте и одинаковом профиле запросов. DGX Spark или RTX 4090 для локальных LLM.